Correlation structure#
import os
import torch
import matplotlib.pyplot as plt

torch.manual_seed(42)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

n_epochs = int(os.getenv("GPYTORCHQR_N_EPOCHS", 5000))
Input data#
def mean(x):
    # x: (N, 1)
    return torch.cos(x.squeeze(-1) * 2 * 3.14)


def std(x):
    # x: (N, 1)
    return x.squeeze(-1) + 0.1


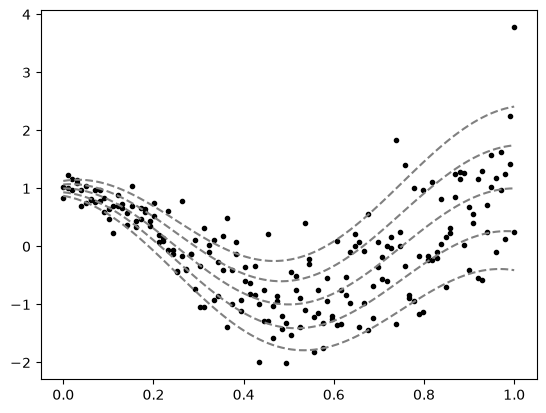
x_range = torch.linspace(0, 1, 100, device=device).reshape(-1, 1)
x = x_range.repeat(2, 1)
y = mean(x) + torch.randn(len(x), device=device).mul(std(x))
q = torch.tensor([0.1, 0.25, 0.5, 0.75, 0.9], device=device)
standard_normal = torch.distributions.Normal(
    torch.zeros((), device=device), torch.ones((), device=device)
)
icdf = standard_normal.icdf(q)
true_quantiles = mean(x_range).unsqueeze(1) + std(x_range).unsqueeze(1) * icdf

x_pred = torch.linspace(0, 1.5, 100, device=device).reshape(-1, 1)
plt.scatter(x.cpu(), y.cpu(), c="k", marker=".")
plt.plot(x_range.cpu(), true_quantiles.cpu(), "--", c="gray")
plt.show()
Direct GPQR#
LMC#
from gpytorch.means import ConstantMean
from gpytorch.kernels import ScaleKernel, RBFKernel
from gpytorch.variational import (
    CholeskyVariationalDistribution,
    VariationalStrategy,
    LMCVariationalStrategy,
)
from gpytorch_qr.models import DirectQuantileGP
from gpytorch_qr.likelihoods import DirectQuantilesLikelihood


class QuantileGPModel(DirectQuantileGP):
    def __init__(
        self,
        inducing_points,
        num_quantiles,
        num_latents,
    ):
        N, D = inducing_points.size()
        variational_distribution = CholeskyVariationalDistribution(
            N,
            batch_shape=torch.Size([num_latents]),
        )
        variational_strategy = LMCVariationalStrategy(
            VariationalStrategy(
                self,
                inducing_points,
                variational_distribution,
                learn_inducing_locations=True,
            ),
            num_quantiles,
            num_latents,
        )

        mean = ConstantMean(batch_shape=torch.Size([num_latents]))
        covar = ScaleKernel(
            RBFKernel(ard_num_dims=D, batch_shape=torch.Size([num_latents])),
            batch_shape=torch.Size([num_latents]),
        )
        super().__init__(variational_strategy, mean, covar)


inducing_points = torch.linspace(0, 1, 10, device=device).reshape(-1, 1)
num_latents = 3

likelihood = DirectQuantilesLikelihood(q).to(device)
model = QuantileGPModel(
    inducing_points,
    len(q),
    num_latents,
).to(device)
from gpytorch.mlls import VariationalELBO

model.train()
likelihood.train()

optimizer = torch.optim.Adam(
    list(model.parameters()) + list(likelihood.parameters()),
    lr=0.001,
)
mll = VariationalELBO(likelihood, model, num_data=y.numel())
for _ in range(n_epochs):
    output = model(x)
    loss = -mll(output, y)
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
model.eval()
likelihood.eval()

with torch.no_grad():
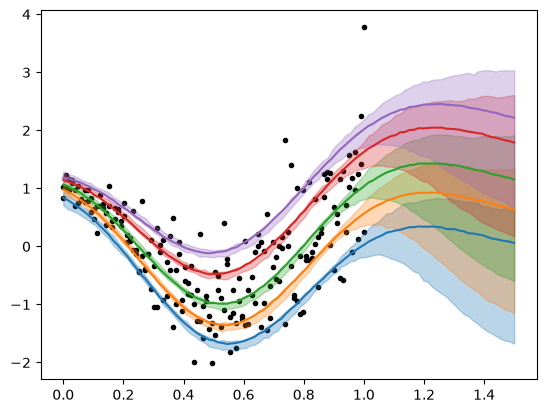
    mean_q = model.mean_quantiles_mc(x_pred)
    lower_q, upper_q = model.quantile_quantiles_mc(
        x_pred, torch.tensor([0.025, 0.975], device=device)
    )

pred_mean_q = mean_q.detach().cpu()
pred_lower_q = lower_q.detach().cpu()
pred_upper_q = upper_q.detach().cpu()
colors = plt.cm.tab10.colors

plt.scatter(x.cpu(), y.cpu(), c="k", marker=".")

for i in range(len(q)):
    plt.plot(x_pred.cpu(), pred_mean_q[:, i].cpu(), color=colors[i])
    plt.fill_between(
        x_pred.cpu().squeeze(),
        pred_lower_q[:, i].cpu(),
        pred_upper_q[:, i].cpu(),
        color=colors[i],
        alpha=0.3,
    )
plt.show()
Center-Gap GPQR#
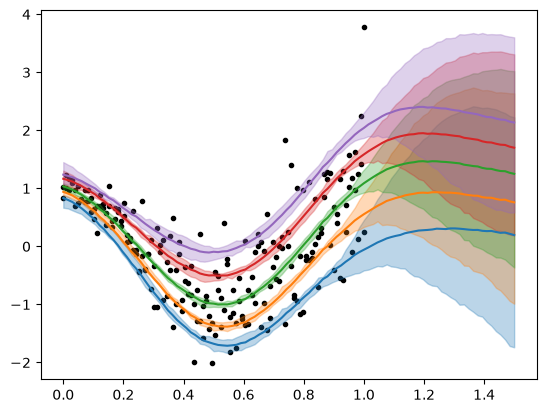
In center-gap GPQR, one output GP is a central quantile while other output GPs are gaps. Standard LMC is undesirable in this setting because it linearly combines all latent GPs to acquire all output GPs.
Instead, it is recommended to use CenterGapLMCVariationalStrategy to separate central quantile and gaps.
Standard LMC#
from gpytorch.means import ConstantMean
from gpytorch.kernels import ScaleKernel, RBFKernel
from gpytorch.variational import (
    CholeskyVariationalDistribution,
    VariationalStrategy,
    LMCVariationalStrategy,
)
from gpytorch_qr.models import CenterGapQuantileGP
from gpytorch_qr.likelihoods import CenterGapQuantilesLikelihood


class QuantileGPModel(CenterGapQuantileGP):
    def __init__(
        self,
        inducing_points,
        num_quantiles,
        num_lower_quantiles,
        num_latents,
    ):
        N, D = inducing_points.size()
        variational_distribution = CholeskyVariationalDistribution(
            N,
            batch_shape=torch.Size([num_latents]),
        )
        variational_strategy = LMCVariationalStrategy(
            VariationalStrategy(
                self,
                inducing_points,
                variational_distribution,
                learn_inducing_locations=True,
            ),
            num_quantiles,
            num_latents,
        )

        mean = ConstantMean(batch_shape=torch.Size([num_latents]))
        covar = ScaleKernel(
            RBFKernel(ard_num_dims=D, batch_shape=torch.Size([num_latents])),
            batch_shape=torch.Size([num_latents]),
        )
        super().__init__(
            variational_strategy, mean, covar, [num_quantiles], [num_lower_quantiles]
        )


inducing_points = torch.linspace(0, 1, 10, device=device).reshape(-1, 1)
central_q_index = 2
num_latents = 3

likelihood = CenterGapQuantilesLikelihood(q, central_q_index).to(device)
model = QuantileGPModel(
    inducing_points,
    len(q),
    central_q_index,
    num_latents,
).to(device)
from gpytorch.mlls import VariationalELBO

model.train()
likelihood.train()

optimizer = torch.optim.Adam(
    list(model.parameters()) + list(likelihood.parameters()),
    lr=0.001,
)
mll = VariationalELBO(likelihood, model, num_data=y.numel())
for _ in range(n_epochs):
    output = model(x)
    loss = -mll(output, y)
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
model.eval()
likelihood.eval()

with torch.no_grad():
    mean_q = model.mean_quantiles_mc(x_pred)
    lower_q, upper_q = model.quantile_quantiles_mc(
        x_pred, torch.tensor([0.025, 0.975], device=device)
    )

pred_mean_q = mean_q.detach().cpu()
pred_lower_q = lower_q.detach().cpu()
pred_upper_q = upper_q.detach().cpu()
colors = plt.cm.tab10.colors

plt.scatter(x.cpu(), y.cpu(), c="k", marker=".")

for i in range(len(q)):
    plt.plot(x_pred.cpu(), pred_mean_q[:, i].cpu(), color=colors[i])
    plt.fill_between(
        x_pred.cpu().squeeze(),
        pred_lower_q[:, i].cpu(),
        pred_upper_q[:, i].cpu(),
        color=colors[i],
        alpha=0.3,
    )
plt.show()
Center-gap LMC#
from gpytorch.means import ConstantMean
from gpytorch.kernels import ScaleKernel, RBFKernel
from gpytorch.variational import (
    CholeskyVariationalDistribution,
    VariationalStrategy,
)
from gpytorch_qr.models import CenterGapQuantileGP
from gpytorch_qr.likelihoods import CenterGapQuantilesLikelihood
from gpytorch_qr.variational import CenterGapLMCVariationalStrategy


class QuantileGPModel(CenterGapQuantileGP):
    def __init__(
        self,
        inducing_points,
        num_quantiles,
        num_lower_quantiles,
        num_latents,
    ):
        N, D = inducing_points.size()
        variational_distribution = CholeskyVariationalDistribution(
            N,
            batch_shape=torch.Size([num_latents]),
        )
        variational_strategy = CenterGapLMCVariationalStrategy(
            VariationalStrategy(
                self,
                inducing_points,
                variational_distribution,
                learn_inducing_locations=True,
            ),
            num_quantiles,
            num_latents,
        )

        mean = ConstantMean(batch_shape=torch.Size([num_latents]))
        covar = ScaleKernel(
            RBFKernel(ard_num_dims=D, batch_shape=torch.Size([num_latents])),
            batch_shape=torch.Size([num_latents]),
        )
        super().__init__(
            variational_strategy, mean, covar, [num_quantiles], [num_lower_quantiles]
        )


inducing_points = torch.linspace(0, 1, 10, device=device).reshape(-1, 1)
central_q_index = 2
num_latents = 3

likelihood = CenterGapQuantilesLikelihood(q, central_q_index).to(device)
model = QuantileGPModel(
    inducing_points,
    len(q),
    central_q_index,
    num_latents,
).to(device)
from gpytorch.mlls import VariationalELBO

model.train()
likelihood.train()

optimizer = torch.optim.Adam(
    list(model.parameters()) + list(likelihood.parameters()),
    lr=0.001,
)
mll = VariationalELBO(likelihood, model, num_data=y.numel())
for _ in range(n_epochs):
    output = model(x)
    loss = -mll(output, y)
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
model.eval()
likelihood.eval()

with torch.no_grad():
    mean_q = model.mean_quantiles_mc(x_pred)
    lower_q, upper_q = model.quantile_quantiles_mc(
        x_pred, torch.tensor([0.025, 0.975], device=device)
    )

pred_mean_q = mean_q.detach().cpu()
pred_lower_q = lower_q.detach().cpu()
pred_upper_q = upper_q.detach().cpu()
colors = plt.cm.tab10.colors

plt.scatter(x.cpu(), y.cpu(), c="k", marker=".")

for i in range(len(q)):
    plt.plot(x_pred.cpu(), pred_mean_q[:, i].cpu(), color=colors[i])
    plt.fill_between(
        x_pred.cpu().squeeze(),
        pred_lower_q[:, i].cpu(),
        pred_upper_q[:, i].cpu(),
        color=colors[i],
        alpha=0.3,
    )
plt.show()
